چطور متن را به صدای طبیعی تبدیل کنیم؟
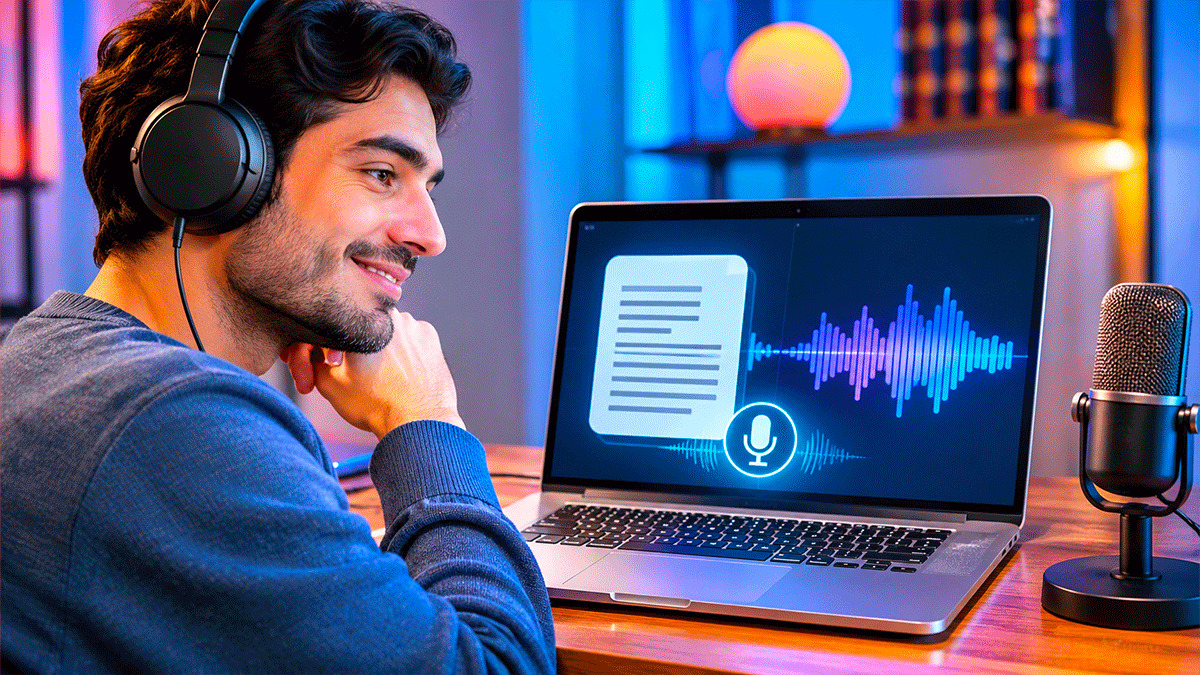
با استفاده از ابزارهای تبدیل متن به گفتار (Text to Speech یا TTS)، می توان یک متن را وارد نرم افزار کرد و نسخه صوتی آن را با صدای تولیدشده توسط هوش مصنوعی دریافت کرد. برای این کار به میکروفون، گوینده یا تجهیزات ضبط صدا نیاز ندارید.
اگر می خواهید متن فارسی یا انگلیسی را به صدایی روان و قابل فهم تبدیل کنید، باید علاوه بر انتخاب ابزار مناسب، به عواملی مانند تلفظ واژه ها، مکث میان جمله ها، لحن گوینده و تنظیم سرعت خواندن توجه داشته باشید. در ادامه، روش تبدیل متن به صدای طبیعی، ابزارهای قابل اعتماد و نکاتی را بررسی می کنیم که به بهبود نتیجه کمک می کنند.
تبدیل متن به گفتار (TTS) چیست؟
فناوری Text to Speech یا TTS متن نوشتاری را به گفتار تبدیل می کند. در روش های قدیمی، صداها بر اساس الگوهای از پیش تعیین شده و قواعد زبانی ساخته می شدند. به همین دلیل، خروجی برخی از این سیستم ها حالت ماشینی داشت و در بیان جمله های طولانی یا واژه های خاص چندان روان نبود.
سیستم های جدید از مدل های هوش مصنوعی برای تولید صدا استفاده می کنند. این مدل ها با تحلیل متن و الگوهای گفتاری، صداهایی با ریتم، مکث و آهنگ طبیعی تر می سازند. بعضی ابزارها امکان انتخاب گوینده، زبان، لحن و سرعت خواندن را نیز در اختیار کاربر قرار می دهند.
چطور متن را به صدای طبیعی تبدیل کنیم؟
برای تبدیل نوشته به فایل صوتی، ابتدا باید یک ابزار تبدیل متن به گفتار انتخاب کنید. سپس متن را وارد کنید، صدای مناسب را برگزینید و خروجی را بررسی کنید. جزئیات این مراحل در پلتفرم های مختلف کمی تفاوت دارد، اما روند کلی به شکل زیر است.
۱. متن را برای خواندن صوتی آماده کنید
پیش از وارد کردن نوشته، آن را از نظر نگارشی بررسی کنید. متنی که برای مطالعه روی صفحه مناسب است، لزوما برای خواندن با صدا ساختار خوبی ندارد. جمله های بسیار طولانی، نشانه گذاری نامناسب و عبارت های پیچیده می توانند باعث شوند گوینده مصنوعی متن را با مکث های نامناسب یا آهنگ غیرطبیعی بخواند.
برای آماده سازی متن به این نکات توجه کنید:
- جمله های طولانی را به چند جمله کوتاه تر تقسیم کنید.
- از نقطه، ویرگول و علامت سوال در جای مناسب استفاده کنید.
- مخفف ها و واژه های تخصصی را در صورت نیاز به شکل خواناتر بنویسید.
- اعداد، تاریخ ها و نشانه های اختصاری را بررسی کنید تا به شکل مورد نظر خوانده شوند.
- اگر متن شامل گفت و گو است، گوینده هر جمله را مشخص کنید.
برای مثال، در یک متن آموزشی بهتر است دستورالعمل ها با جمله های کوتاه و روشن نوشته شوند. این کار به حفظ ریتم گفتار کمک می کند و احتمال مکث های نامناسب را کاهش می دهد.
۲. ابزار و زبان مناسب را انتخاب کنید
اگر قصد تولید محتوای فارسی دارید، ابتدا یک پاراگراف نمونه را در ابزار مورد نظر آزمایش کنید. بعضی سرویس ها در تولید صدای انگلیسی عملکرد مناسبی دارند، اما ممکن است برای فارسی، نام های خاص یا واژه های تخصصی نتیجه مطلوبی نداشته باشند.
۳. صدای گوینده و سبک بیان را تنظیم کنید
برای یک ویدیوی آموزشی، صدای واضح و رسمی مناسب تر است و برای داستان یا محتوای سرگرمی می توان از لحن محاوره ای استفاده کرد.
در صورت وجود تنظیمات مربوط به سرعت و لحن، آن ها را با هدف محتوا هماهنگ کنید. سرعت زیاد ممکن است فهم جمله ها را دشوار کند و سرعت بسیار پایین نیز ریتم گفتار را از بین ببرد.
۴. خروجی صوتی را بررسی و اصلاح کنید
پس از تولید صدا، فایل را از ابتدا تا انتها گوش دهید. فقط به کیفیت کلی صدا توجه نکنید؛ تلفظ نام ها، اعداد، عبارت های انگلیسی و واژه های تخصصی را نیز بررسی کنید. اگر بخشی از متن نامفهوم است، ممکن است لازم باشد جمله را بازنویسی کنید یا نشانه گذاری آن را تغییر دهید.
بهترین ابزارها برای تبدیل متن به صدای طبیعی
ابزارهای تبدیل متن به گفتار از نظر زبان های پشتیبانی شده، تنوع صدا، کنترل لحن و امکانات ویرایش تفاوت دارند. انتخاب مناسب به نوع استفاده شما بستگی دارد. برای مثال، ابزاری که برای شنیدن مقاله و فایل PDF طراحی شده، ممکن است امکانات مورد نیاز یک تولیدکننده محتوای ویدیویی را نداشته باشد.
۱- Google Cloud Text-to-Speech و Gemini
مناسب برای: تولید گفتار به زبان های مختلف، از جمله فارسی، و پروژه هایی که به کنترل بیشتر روی نحوه بیان نیاز دارند.
سرویس صوتی گوگل با استفاده از مدل های تبدیل متن به گفتار، نوشته را به فایل صوتی تبدیل می کند. در مستندات رسمی این سرویس، زبان فارسی ایران با کد fa-IR در فهرست زبان های پشتیبانی شده قرار دارد. مدل های Gemini TTS نیز برای تولید گفتار با کنترل لحن، سرعت و شیوه بیان طراحی شده اند. این قابلیت برای ساخت روایت صوتی و مکالمه میان دو گوینده کاربرد دارد.
برای استفاده، باید سرویس را در محیط Google Cloud راه اندازی کنید و تنظیمات لازم را انجام دهید. بنابراین ممکن است شروع کار با آن نسبت به ابزارهای ساده تحت وب کمی فنی تر باشد. اگر اولویت شما تولید صدای فارسی است، پشتیبانی مستند از این زبان یک مزیت مهم محسوب می شود.
2- ElevenLabs
مناسب برای: تولید صدای انگلیسی و زبان های پشتیبانی شده، ساخت روایت، کتاب صوتی و محتوای چندگوینده.
ElevenLabs یکی از سرویس های شناخته شده در زمینه تولید صدای هوش مصنوعی است. این پلتفرم مدل های مختلفی برای تبدیل متن به گفتار دارد که از نظر سرعت تولید، کیفیت بیان و زبان های پشتیبانی شده با هم تفاوت دارند. بعضی مدل ها برای تولید سریع صدا طراحی شده اند و برخی دیگر در بیان احساسی و محتوای طولانی عملکرد مناسب تری دارند. پیش از انتخاب این سرویس برای یک پروژه فارسی، نمونه خروجی را آزمایش کنید.
برای دسترسی به امکانات بیشتر ElevenLabs و استفاده از قابلیت های پیشرفته تولید صدا، می توانید اشتراک این سرویس را از سایت های معتبری مانند heavenaccount.com خریداری کنید.
3- Canva AI Voice
مناسب برای: صداگذاری ویدیو، ارائه، محتوای شبکه های اجتماعی و آموزش. کانوا علاوه بر امکانات طراحی، ابزار تولید صدای هوش مصنوعی نیز دارد. با استفاده از این قابلیت می توانید متن گویندگی را وارد کنید، از میان صداهای موجود انتخاب کنید و صدای تولیدشده را به پروژه ویدیویی یا ارائه خود اضافه کنید. یکی از مزیت های این روش آن است که صداگذاری و ویرایش محتوای تصویری در یک محیط انجام می شوند.
برای استفاده از این قابلیت، طرح مورد نظر را باز کنید و از بخش برنامه ها یا قسمت صوتی، گزینه AI Voice را انتخاب کنید. سپس متن را وارد کنید، زبان و صدای مناسب را برگزینید و تولید صدا را آغاز کنید. پس از شنیدن پیش نمایش، می توانید فایل صوتی را در تایم لاین پروژه تنظیم کنید. راهنمای رسمی Canva مراحل استفاده از این قابلیت را توضیح داده است.
4- NaturalReader
مناسب برای: شنیدن متن مقاله، فایل PDF، کتاب الکترونیکی و اسناد. نچرال ریدر بیشتر برای تبدیل محتوای نوشتاری به گفتار و گوش دادن به آن طراحی شده است. می توانید متن را در محیط ابزار وارد کنید یا فایل های پشتیبانی شده را بارگذاری کنید تا محتوای آن ها با صدای هوش مصنوعی خوانده شود. امکان تنظیم سرعت، انتخاب صدا و کنترل مکث میان جمله ها نیز در نسخه شخصی وجود دارد.
در انتخاب نسخه این ابزار باید به تفاوت استفاده شخصی و تجاری توجه کنید. نسخه شخصی برای گوش دادن خصوصی به متن طراحی شده و مجوز آن برای انتشار فایل صوتی در ویدیو، پادکست یا محتوای عمومی کافی نیست. برای تولید و انتشار صداگذاری باید شرایط نسخه تجاری و مجوز مربوط به آن را بررسی کنید.
چطور صدای تولیدشده را طبیعی تر کنیم؟
حتی مدل های پیشرفته نیز ممکن است بعضی جمله ها را با مکث نامناسب بخوانند یا در تلفظ نام ها و اصطلاحات تخصصی اشتباه کنند. با رعایت چند نکته می توانید خروجی را به گفتار طبیعی نزدیک تر کنید.
علائم نگارشی فقط برای خوانایی متن نیستند؛ در تولید گفتار نیز بر مکث و آهنگ جمله اثر می گذارند. نقطه پایان جمله را مشخص می کند، ویرگول مکث کوتاه تری ایجاد می کند و علامت سوال می تواند به تغییر آهنگ جمله کمک کند.
برای مثال، اگر یک پاراگراف طولانی بدون نقطه و ویرگول وارد ابزار کنید، ممکن است صدای تولید شده آن را بدون مکث مناسب بخواند. بهتر است متن را به جمله های مستقل تقسیم کنید و نشانه گذاری را متناسب با نحوه بیان مورد نظر خود تغییر دهید.
تقسیم متن به بخش های کوتاه در تدوین نهایی نیز مفید است. می توانید فاصله میان بخش ها را تنظیم کنید، موسیقی پس زمینه را در محل مناسب قرار دهید و صدای هر قسمت را جداگانه بررسی کنید.
کاربردهای تبدیل متن به صدای طبیعی
تبدیل متن به گفتار فقط برای ساخت فایل صوتی از مقاله کاربرد ندارد. این فناوری در تولید محتوا، آموزش، دسترس پذیری و استفاده روزمره نیز نقش دارد.
- تولید ویدیوهای آموزشی: مدرس ها و تولیدکنندگان محتوا می توانند متن درس یا توضیحات خود را به صدا تبدیل کنند و آن را روی ویدیو قرار دهند. این روش برای ساخت آموزش های نرم افزاری، ویدیوهای توضیحی و محتوای آموزشی کوتاه کاربرد دارد.
- ساخت پادکست و کتاب صوتی: متن داستان، مقاله یا محتوای آموزشی را می توان به نسخه صوتی تبدیل کرد. البته برای انتشار عمومی یا تجاری باید مجوز استفاده از صدای تولیدشده و شرایط سرویس انتخابی بررسی شود.
- شنیدن مقاله و اسناد: دانشجوها و افرادی که با حجم زیادی از مطالب نوشتاری سروکار دارند، می توانند فایل های متنی و اسناد را به گفتار تبدیل کنند. این روش امکان شنیدن محتوا هنگام انجام فعالیت های دیگر را نیز ایجاد می کند.
- تولید محتوای چندزبانه: بعضی ابزارها از زبان ها و لهجه های مختلف پشتیبانی می کنند. در نتیجه، تولیدکننده محتوا می تواند نسخه صوتی یک متن را برای مخاطبان زبان های مختلف آماده کند. البته ترجمه متن و تولید صدای آن دو مرحله جداگانه هستند و باید هر دو از نظر صحت بررسی شوند.
- کمک به دسترس پذیری محتوا: تبدیل نوشته به گفتار می تواند مطالعه محتوای دیجیتال را برای افرادی که در خواندن متن روی صفحه مشکل دارند، آسان تر کند. همچنین شنیدن متن برای بعضی کاربران در مقایسه با مطالعه طولانی راحت تر است.
مشکلات رایج هنگام تبدیل متن به گفتار و راه حل آن ها
گاهی خروجی ابزار با انتظاری که از صدای طبیعی دارید فاصله دارد. در بیشتر موارد، می توان با بررسی متن ورودی، تنظیمات صدا و محدودیت های ابزار مشکل را شناسایی کرد.
|
مشکل |
راه حل پیشنهادی |
|
تلفظ اشتباه کلمات فارسی |
بررسی پشتیبانی ابزار از فارسی و اصلاح شکل نوشتاری واژه |
|
مکث های نامناسب |
بازنویسی جمله ها و اصلاح علائم نگارشی |
|
سرعت بیش از حد زیاد |
کاهش سرعت خواندن در تنظیمات صدا |
|
لحن یکنواخت |
انتخاب صدای دیگر یا تنظیم سبک بیان |
|
اشتباه در خواندن اعداد |
نوشتن اعداد به حروف در بخش های حساس |
|
قطع شدن خروجی |
تقسیم متن به بخش های کوتاه تر و بررسی محدودیت ورودی ابزار |
|
تفاوت لحن در بخش های مختلف |
استفاده از یک صدای ثابت و تنظیمات یکسان برای تمام قسمت ها |
یکی از مشکلات مهم در تولید فایل صوتی فارسی، خواندن نادرست واژه های دارای چند تلفظ است. در چنین شرایطی، بهتر است ابتدا یک نمونه کوتاه تولید کنید و قبل از پردازش کل متن، تلفظ واژه های حساس را بررسی کنید.
آیا تبدیل متن به صدای طبیعی رایگان است؟
همچنین رایگان بودن تولید صدا به معنای داشتن مجوز انتشار آن نیست. برای مثال، در NaturalReader نسخه شخصی برای استفاده خصوصی طراحی شده و انتشار فایل صوتی تولیدشده در ویدیو یا پادکست به مجوز تجاری نیاز دارد. در ElevenLabs نیز حقوق استفاده تجاری به نوع اشتراک وابسته است.
پیش از انتخاب سرویس، این موارد را بررسی کنید:
- محدودیت تعداد کاراکتر یا مدت زمان تولید صدا
- امکان دانلود فایل صوتی
- فرمت های خروجی
- دسترسی به صداهای مختلف و زبان مورد نظر
- مجوز استفاده شخصی یا تجاری
- نحوه نگهداری و پردازش متن و فایل های بارگذاری شده
اگر قصد دارید صدا را در فضای عمومی یا تجاری منتشر کنید، شرایط مجوز را در صفحه رسمی همان سرویس بخوانید. این موضوع به ویژه برای ویدیوهای درآمدزا، تبلیغات و محصولات آموزشی اهمیت دارد.
منبع خبر: cloud.google.com